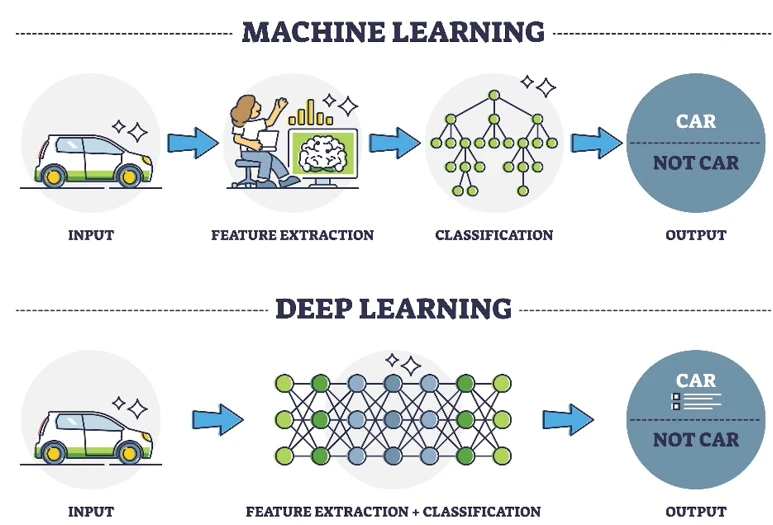
TentangAI.com – Perbedaan utama terletak pada hierarki dan kompleksitasnya: Deep Learning adalah subbidang khusus dari machine learning. Jika Machine Learning memerlukan intervensi manusia untuk memilih fitur data (feature engineering), Deep Learning menggunakan arsitektur saraf tiruan untuk mempelajari fitur secara otomatis dari data mentah dalam skala besar.
Deep learning membutuhkan ribuan hingga jutaan contoh data untuk mencapai potensi penuhnya, jauh melampaui kebutuhan Machine Learning yang hanya memerlukan ratusan atau ribuan contoh saja.
Decision Matrix: Kapan Harus Memilih Machine Learning vs Deep Learning?
Pilihlah Machine Learning jika Anda memiliki data terstruktur dalam jumlah terbatas, anggaran komputasi rendah, dan membutuhkan model yang mudah dijelaskan (interpretability). Gunakan Deep Learning jika Anda bekerja dengan data tidak terstruktur (gambar/suara), memiliki jutaan dataset, dan memiliki akses ke GPU/TPU untuk pemrosesan intensif.
| Kriteria | Machine Learning | Deep Learning |
|---|---|---|
| Jenis Data | Terstruktur (Tabel/Excel) | Tidak Terstruktur (Gambar/Audio) |
| Volume Data | Ratusan hingga ribuan | Ribuan hingga jutaan |
| Interpretabilitas | Tinggi (Mudah dijelaskan) | Rendah (Black Box) |
| Sumber Daya | CPU (Rendah) | GPU/TPU (Tinggi) |
Machine learning bekerja dengan sangat baik pada data terstruktur yang lebih kecil, sedangkan deep learning membutuhkan dataset besar yang seringkali mencakup ribuan hingga jutaan contoh agar dapat mencapai performa optimal.
Pertimbangan Budget dan Infrastruktur
Berdasarkan informasi dari TechTarget, model machine learning biasanya lebih cepat dalam proses pelatihan dan membutuhkan daya komputasi yang jauh lebih rendah. Sebaliknya, deep learning membutuhkan sumber daya komputasi yang sangat besar karena arsitektur jaringan sarafnya yang kompleks.
Urgensi Waktu (Time-to-Market)
Meskipun deep learning menawarkan akurasi tinggi pada tugas tertentu, waktu pengembangan seringkali lebih lama. Hal ini disebabkan oleh kebutuhan untuk mengumpulkan jutaan data dan melakukan pelatihan model yang memakan waktu lama. Jika target Anda adalah rilis produk dengan cepat menggunakan data yang sudah tersedia secara terstruktur, machine learning adalah pilihan yang lebih efisien.
Analisis Explainability Gap: Mengapa Deep Learning Disebut ‘Black Box’?
Namun, model deep learning lebih sulit untuk dipahami, terutama dalam hal bagaimana lapisan dan parameternya berinteraksi.
Model deep learning lebih sulit untuk dipahami, terutama dalam hal bagaimana lapisan dan parameternya berinteraksi.
Dampak pada Industri Medis dan Perbankan
Ketidakmampuan untuk menjelaskan proses pengambilan keputusan menjadi hambatan kritis di sektor dengan regulasi ketat. Dalam skenario ini, machine learning yang lebih transparan seringkali lebih disukai daripada model deep learning yang sangat akurat namun tidak dapat dijelaskan.
Transparansi vs Akurasi
Terdapat perdagangan antara akurasi dan transparansi. Model machine learning umumnya lebih mudah diinterpretasi dan lebih transparan dalam menunjukkan fitur mana yang paling berpengaruh terhadap hasil akhir.
Memahami Hierarki: Hubungan AI, Machine Learning, dan Deep Learning
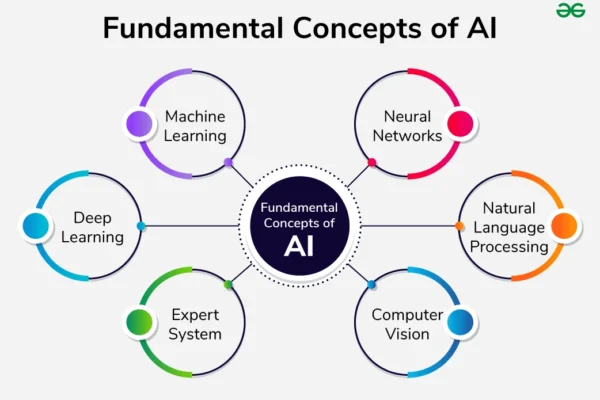
Secara hierarkis, Artificial Intelligence (AI) adalah payung besarnya. Machine Learning adalah subset dari AI yang belajar dari data, sementara Deep Learning adalah subbidang khusus dari Machine Learning yang menggunakan jaringan saraf tiruan berlapis banyak.
TechTarget menjelaskan bahwa
“Machine learning is a subset of AI that refers to systems that can learn from data.”
Artinya: Machine learning adalah subset dari AI yang merujuk pada sistem yang dapat belajar dari data. Sementara itu, Syracuse University iSchool menegaskan bahwa
“Deep learning is a specialized subfield of machine learning.”
Artinya: deep learning adalah subbidang khusus dari machine learning.
Mekanisme Kerja: Feature Engineering Manual vs Otomatis
Perbedaan teknis yang paling mendasar terletak pada bagaimana fitur data diekstraksi. Pada machine learning, proses ini melibatkan peran aktif manusia dalam menentukan karakteristik mana yang penting bagi model.
- Machine Learning: Memerlukan pemilihan fitur secara manual (manual feature selection) oleh data scientist untuk membantu model mengenali pola.
- Deep Learning: Secara otomatis mempelajari fitur dari data mentah (raw data) melalui berbagai lapisan saraf.
Peran Data Scientist dalam Machine Learning
Dalam alur kerja machine learning, seorang data scientist harus melakukan proses pelabelan data dan memilih fitur yang relevan secara manual agar model dapat bekerja secara optimal.
Otomasi Arsitektur pada Deep Learning
Deep learning secara otomatis mempelajari fitur dari data mentah (raw data) melalui berbagai lapisan saraf.
Kebutuhan Sumber Daya: Komputasi dan Skala Data
Volume data yang dibutuhkan untuk melatih model sangat menentukan jenis algoritma yang digunakan. Machine learning dapat memberikan hasil optimal hanya dengan menggunakan beberapa ratus atau ribuan contoh saja. Sebaliknya, deep learning membutuhkan ribuan atau bahkan jutaan contoh untuk mencapai potensi penuhnya.
Skalabilitas Data
Ada perbedaan drastis dalam skala kebutuhan data. Jika dataset Anda hanya berjumlah ratusan, menggunakan deep learning adalah pemborosan sumber daya karena model tersebut tidak akan memiliki cukup informasi untuk membentuk pola yang kuat.
Kebutuhan Hardware (CPU vs GPU)
Machine learning umumnya dapat dijalankan dengan efisien menggunakan CPU standar. Namun, deep learning membutuhkan sumber daya komputasi yang sangat besar karena kompleksitas arsitektur jaringan sarafnya, sehingga penggunaan GPU atau TPU menjadi kebutuhan wajib untuk mempercepat proses pelatihan.
Risiko Kegagalan: Kapan Model Anda Bisa Berbahaya?
Menggunakan model kecerdasan buatan tanpa pengujian yang memadai dapat menimbulkan risiko serius, terutama jika model tersebut diimplementasikan dalam kondisi dunia nyata yang tidak terduga.
Overfitting pada Dataset Kecil
Tanpa jumlah data yang cukup, deep learning berisiko menghafal contoh pelatihan (memorizing training examples) alih-alih mempelajari pola umum.
Serangan Adversarial pada Neural Networks
Menurut Microsoft Learn, terdapat risiko di mana jaringan saraf dalam dapat diprogram ulang melalui kueri khusus dari pihak lawan (adversary). Serangan adversarial ini dapat memanipulasi input secara halus sehingga model memberikan output yang salah namun terlihat normal bagi manusia.
Implementasi Praktis: Teknik dan Algoritma Populer
Pemilihan algoritma bergantung pada tujuan tugas, apakah Anda ingin mengklasifikasikan data, menemukan pola tersembunyi, atau melatih agen untuk mengambil keputusan melalui trial and error.
Algoritma Klasik Machine Learning
Machine learning menyediakan berbagai metode untuk berbagai kebutuhan, di antaranya:
- Supervised Learning: Belajar dari data yang sudah memiliki label.
- Unsupervised Learning: Mencari struktur atau pola tersembunyi dalam data tanpa label.
- Reinforcement Learning: Belajar melalui uji coba untuk mencapai imbalan terbaik.
Arsitektur Modern Deep Learning
Untuk tugas yang lebih kompleks, arsitektur deep learning berikut sering digunakan:
- convolutional neural networks (CNNs): Sangat efektif untuk tugas pengenalan gambar.
- Recurrent Neural Networks (RNNs): Digunakan untuk data berbasis urutan atau sekuensial.
- Transformers: Arsitektur modern yang dominan dalam pemrosesan bahasa alami (NLP).
FAQ
Apakah Deep Learning selalu lebih baik daripada Machine Learning?
Tidak selalu. Deep Learning unggul pada data tidak terstruktur yang masif, namun Machine Learning lebih efisien untuk data terstruktur kecil dan membutuhkan biaya komputasi yang jauh lebih rendah.
Berapa jumlah layer minimum untuk disebut Deep Learning?
Sebuah jaringan saraf tiruan umumnya dianggap sebagai Deep Learning jika memiliki 3 layer atau lebih.
Mengapa Deep Learning sulit dijelaskan?
Karena interaksi kompleks antara ribuan hingga jutaan parameter dalam banyak lapisan tersembunyi (hidden layers) menciptakan fenomena ‘black box’ yang sulit dilacak secara logika manusia.